Catálogo Machine Learning
Del principiante al experto — compre individualmente o en pack con certificado de aprovechamiento.
Las profesiones de Machine Learning transforman necesidades de negocio y datos en modelos predictivos fiables, evaluados, optimizados, desplegados y supervisados. Este itinerario desarrolla competencias utilizadas especialmente por Data Scientists y Machine Learning Engineers, profundizando en los modelos, su evaluación, optimización y ciclo de vida técnico, desde la experimentación hasta la puesta en producción. Estas competencias de Machine Learning se profundizan después y se integran en un enfoque profesional más amplio dentro del itinerario Data Scientist, que también cubre el planteamiento de negocio, la experimentación, la causalidad, los datos complejos y la gestión de un producto Data Science.
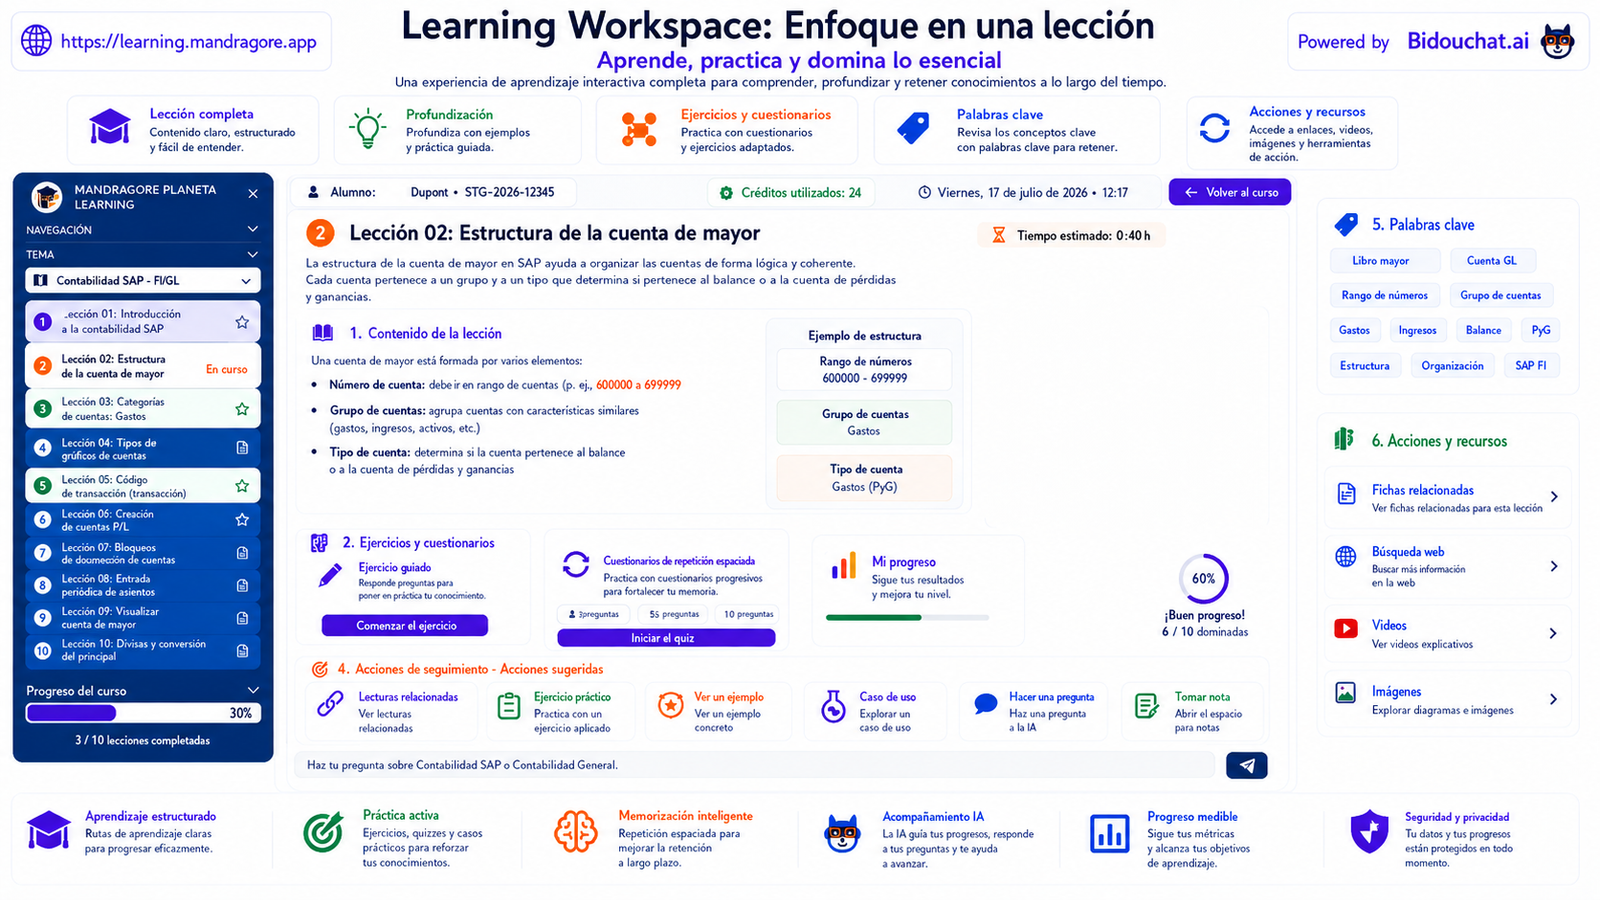
Cada curso reúne 8 lecciones interactivas en un Learning Workspace diseñado para transformar los conocimientos en competencias operativas. Lecciones guiadas, cuestionarios dinámicos, acompañamiento conversacional, casos prácticos, recursos adicionales y seguimiento del progreso te permiten aprender de forma eficaz, a tu ritmo. Los 15 cursos siguen una progresión por niveles, desde el encuadre de un problema de Machine Learning hasta el despliegue, la supervisión y la defensa de una solución predictiva completa.
🎓 15 cursos • 📚 120 lecciones interactivas • ⏱️ de 45 a 75 horas de formación conversacional
⭐ Mejor oferta
Machine Learning — Pack Completo (15 cursos)
ML01 → ML15 · 1 800 créditos incluidos
142,90 € sin IVA
Ahorro : 104,60 €
29,70 €
22,90 sin IVA
Ahorro : 6,80 €
Comprender el Machine Learning y encuadrar un problema
transformar una necesidad de negocio en un problema de Machine Learning medible y decidir si el ML es realmente pertinente
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
No se requiere ningún requisito previo específico para comenzar. Se recomienda soltura con herramientas digitales; los cursos técnicos posteriores pueden utilizar nociones de desarrollo o datos.
- Comprender lo que realmente aporta el Machine Learning
- Identificar clasificación, regresión y otras familias de problemas
- Construir una baseline antes de cualquier modelo complejo
- Taller: decidir si un problema requiere realmente Machine Learning
- Transformar una necesidad de negocio en un problema de Machine Learning medible y decidir si el ML es realmente pertinente
- Distinguir el aprendizaje supervisado y el no supervisado
- Distinguir entrenamiento, validación e inferencia
- Taller: decidir si un problema requiere realmente Machine Learning
de 3 a 5 h
9,90 € sin IVA
Preparar y explorar los datos para el Machine Learning
construir un conjunto de datos explotable sin introducir sesgos, fugas de datos ni incoherencias
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Explorar distribuciones, tipos y calidad de los datos
- Preparar variables numéricas y categóricas
- Detectar desequilibrios y representatividad insuficiente
- Taller: auditar y preparar un dataset antes del modelado
- Construir un conjunto de datos explotable sin introducir sesgos, fugas de datos ni incoherencias
- Gestionar valores ausentes y valores atípicos
- Escalar las variables cuando el modelo lo exige
- Taller: auditar y preparar un dataset antes del modelado
de 3 a 5 h
9,90 € sin IVA
Construir un primer pipeline de ML reproducible
encadenar preprocesamiento, entrenamiento, predicción y evaluación en un flujo de trabajo reproducible
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Instalar un entorno de ML reproducible
- Crear las transformaciones de preprocesamiento
- Calcular y verificar las primeras métricas
- Taller: entregar un primer pipeline de ML reproducible
- Encadenar preprocesamiento, entrenamiento, predicción y evaluación en un flujo de trabajo reproducible
- Construir una baseline con scikit-learn
- Entrenar el pipeline y generar predicciones
- Taller: entregar un primer pipeline de ML reproducible
de 3 a 5 h
9,90 € sin IVA
38,70 €
28,90 sin IVA
Ahorro : 9,80 €
Resolver problemas de regresión
diseñar, comparar y evaluar modelos destinados a predecir un valor numérico
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Comprender un target continuo y construir una baseline
- Comprender la regularización y su interés
- Interpretar el R² sin sobrevalorarlo
- Taller: comparar varios modelos de regresión para una necesidad de negocio
- Diseñar, comparar y evaluar modelos destinados a predecir un valor numérico
- Construir una regresión lineal
- Elegir entre MAE, MSE y RMSE
- Taller: comparar varios modelos de regresión para una necesidad de negocio
de 3 a 5 h
12,90 € sin IVA
Resolver problemas de clasificación
construir modelos de clasificación y elegir las métricas y umbrales adaptados al costo real de los errores
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Comprender las clases y construir una baseline
- Utilizar árboles y Random Forest
- Comparar precision, recall y F1
- Taller: elegir un clasificador según el costo de los errores
- Construir modelos de clasificación y elegir las métricas y umbrales adaptados al costo real de los errores
- Construir una regresión logística
- Leer una matriz de confusión
- Taller: elegir un clasificador según el costo de los errores
de 3 a 5 h
12,90 € sin IVA
Evaluar correctamente y comparar los modelos
obtener una estimación fiable del rendimiento y evitar conclusiones engañosas al seleccionar un modelo
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Comprender el riesgo de una evaluación demasiado optimista
- Evaluar con cross-validation
- Comparar varios modelos con métricas coherentes
- Taller: construir un protocolo de evaluación defendible
- Obtener una estimación fiable del rendimiento y evitar conclusiones engañosas al seleccionar un modelo
- Utilizar un hold-out correctamente
- Respetar el orden temporal con un time split
- Taller: construir un protocolo de evaluación defendible
de 3 a 5 h
12,90 € sin IVA
47,70 €
35,90 sin IVA
Ahorro : 11,80 €
Diseñar y seleccionar las features
crear variables informativas sin fuga de datos y reducir la complejidad cuando mejora el modelo
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Comprender el papel del feature engineering
- Crear variables temporales sin fuga de información
- Utilizar métodos de selección de features
- Taller: mejorar un modelo con features justificadas
- Crear variables informativas sin fuga de datos y reducir la complejidad cuando mejora el modelo
- Crear variables numéricas y transformaciones útiles
- Detectar redundancia y multicolinealidad
- Taller: mejorar un modelo con features justificadas
de 3 a 5 h
15,90 € sin IVA
Optimizar modelos e hiperparámetros
reducir el underfitting y el overfitting y buscar hiperparámetros sin contaminar la evaluación final
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Comprender underfitting, overfitting, sesgo y varianza
- Construir un Grid Search con validación cruzada
- Controlar el tiempo de cálculo y el espacio de búsqueda
- Taller: llevar a cabo y documentar una optimización de hiperparámetros
- Reducir el underfitting y el overfitting y buscar hiperparámetros sin contaminar la evaluación final
- Identificar parámetros aprendidos e hiperparámetros
- Elegir la métrica realmente optimizada
- Taller: llevar a cabo y documentar una optimización de hiperparámetros
de 3 a 5 h
15,90 € sin IVA
Explorar datos sin etiquetas
utilizar clustering, reducción de dimensión y detección de anomalías para comprender estructuras sin un target supervisado
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Comprender los objetivos del aprendizaje no supervisado
- Segmentar con K-means
- Reducir la dimensión con PCA
- Taller: construir e interpretar una segmentación exploratoria
- Utilizar clustering, reducción de dimensión y detección de anomalías para comprender estructuras sin un target supervisado
- Preparar los datos para el clustering
- Descubrir DBSCAN y los clústeres de forma irregular
- Taller: construir e interpretar una segmentación exploratoria
de 3 a 5 h
15,90 € sin IVA
56,70 €
42,90 sin IVA
Ahorro : 13,80 €
Interpretar, explicar y cuestionar los modelos
comprender los factores que influyen en las predicciones e identificar las situaciones en las que una explicación puede ser engañosa
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Distinguir el rendimiento predictivo y la explicabilidad
- Analizar la feature importance con prudencia
- Descubrir las explicaciones locales de tipo SHAP
- Taller: producir un análisis de explicabilidad con sus límites
- Comprender los factores que influyen en las predicciones e identificar las situaciones en las que una explicación puede ser engañosa
- Interpretar coeficientes y parámetros simples
- Comprender los partial dependence plots
- Taller: producir un análisis de explicabilidad con sus límites
de 3 a 5 h
18,90 € sin IVA
Gestionar desequilibrios, sesgos, robustez y fiabilidad
evaluar la calidad de un modelo más allá de una métrica media y controlar sus riesgos en poblaciones y casos difíciles
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Identificar las consecuencias de un fuerte desequilibrio de clases
- Elegir métricas y umbrales para los casos raros
- Probar la robustez y la sensibilidad a datos perturbados
- Taller: cuestionar la fiabilidad de un modelo antes de una decisión
- Evaluar la calidad de un modelo más allá de una métrica media y controlar sus riesgos en poblaciones y casos difíciles
- Utilizar la ponderación y el remuestreo con método
- Comparar el rendimiento entre subgrupos
- Taller: cuestionar la fiabilidad de un modelo antes de una decisión
de 3 a 5 h
18,90 € sin IVA
Trazar los experimentos y gestionar las versiones de modelos
hacer que los experimentos sean comparables, auditables y reproducibles, y luego gestionar el ciclo de vida de los modelos
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Comprender experimento, run y artefacto de ML
- Trazar modelos, figuras y artefactos
- Gestionar versiones, aliases, tags y metadatos
- Taller: construir la trazabilidad completa de un modelo candidato
- Hacer que los experimentos sean comparables, auditables y reproducibles, y luego gestionar el ciclo de vida de los modelos
- Registrar parámetros y métricas con MLflow Tracking
- Registrar un modelo en el Model Registry
- Taller: construir la trazabilidad completa de un modelo candidato
de 3 a 5 h
18,90 € sin IVA
74,70 €
48,90 sin IVA
Ahorro : 25,80 €
Comprender y poner en práctica el Deep Learning
comprender los mecanismos esenciales de las redes neuronales y entrenar un modelo sencillo sin diluir el itinerario en Deep Learning avanzado
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Comprender tensores, capas y red neuronal
- Comprender la función de pérdida y la optimización
- Construir y entrenar una red sencilla con PyTorch
- Taller: comparar una red sencilla con una baseline clásica
- Comprender los mecanismos esenciales de las redes neuronales y entrenar un modelo sencillo sin diluir el itinerario en Deep Learning avanzado
- Elegir funciones de activación y una arquitectura sencilla
- Utilizar batch, epoch y DataLoader
- Taller: comparar una red sencilla con una baseline clásica
de 3 a 5 h
24,90 € sin IVA
Desplegar, supervisar y mantener un modelo de ML
pasar de un modelo validado a un servicio explotable, versionado, observable y mantenible en producción
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Preparar un artefacto fiable para la inferencia
- Exponer un modelo mediante una API de inferencia
- Supervisar la latencia, los errores y la calidad de los datos de entrada
- Taller: desplegar y supervisar un servicio de predicción
- Pasar de un modelo validado a un servicio explotable, versionado, observable y mantenible en producción
- Distinguir batch prediction y online inference
- Gestionar registry, versiones, promoción y rollback
- Taller: desplegar y supervisar un servicio de predicción
de 3 a 5 h
24,90 € sin IVA
Proyecto profesional completo de Machine Learning
diseñar, evaluar, explicar, versionar, desplegar y defender una solución de ML de principio a fin
Información de la formación
Data Analysts, Data Scientists, Machine Learning Engineers y desarrolladores que deseen construir soluciones de Machine Learning fiables y reproducibles.
Se recomienda conocer las bases tratadas anteriormente en el itinerario. Este curso reutiliza y profundiza conceptos introducidos en los cursos previos.
- Encuadrar el problema de churn y el costo de los errores
- Construir pipelines, features y modelos candidatos
- Trazar experimentos y versionar el modelo final
- Taller final: presentar y defender la solución de ML y sus límites
- Diseñar, evaluar, explicar, versionar, desplegar y defender una solución de ML de principio a fin
- Preparar los datos y construir la baseline
- Analizar segmentos, errores y explicabilidad
- Taller final: presentar y defender la solución de ML y sus límites
de 3 a 5 h
24,90 € sin IVA