Catalogus Machine Learning
Van beginner tot expert — koop afzonderlijk of als pakket, met een bewijs van succesvolle afronding.
De taken van machine learning zijn om een bedrijfsbehoefte en gegevens om te zetten in betrouwbare, voorspellende modellen die worden geëvalueerd, geoptimaliseerd, ingezet en gecontroleerd. Deze cursus ontwikkelt de vaardigheden die in het bijzonder worden gebruikt door data-wetenschappers en machine-learning-ingenieurs, door de modellen, hun evaluatie, optimalisatie en hun technische levenscyclus, van experimenteren tot de productie te verdiepen. Deze Machine Learning-vaardigheden worden vervolgens uitgebreid en herplaatst in een bredere bedrijfsbenadering binnen de Data Scientist-cursus, die ook het kaderen, experimenteren, causaliteit, complexe data en het beheren van een Data Science-product omvat.
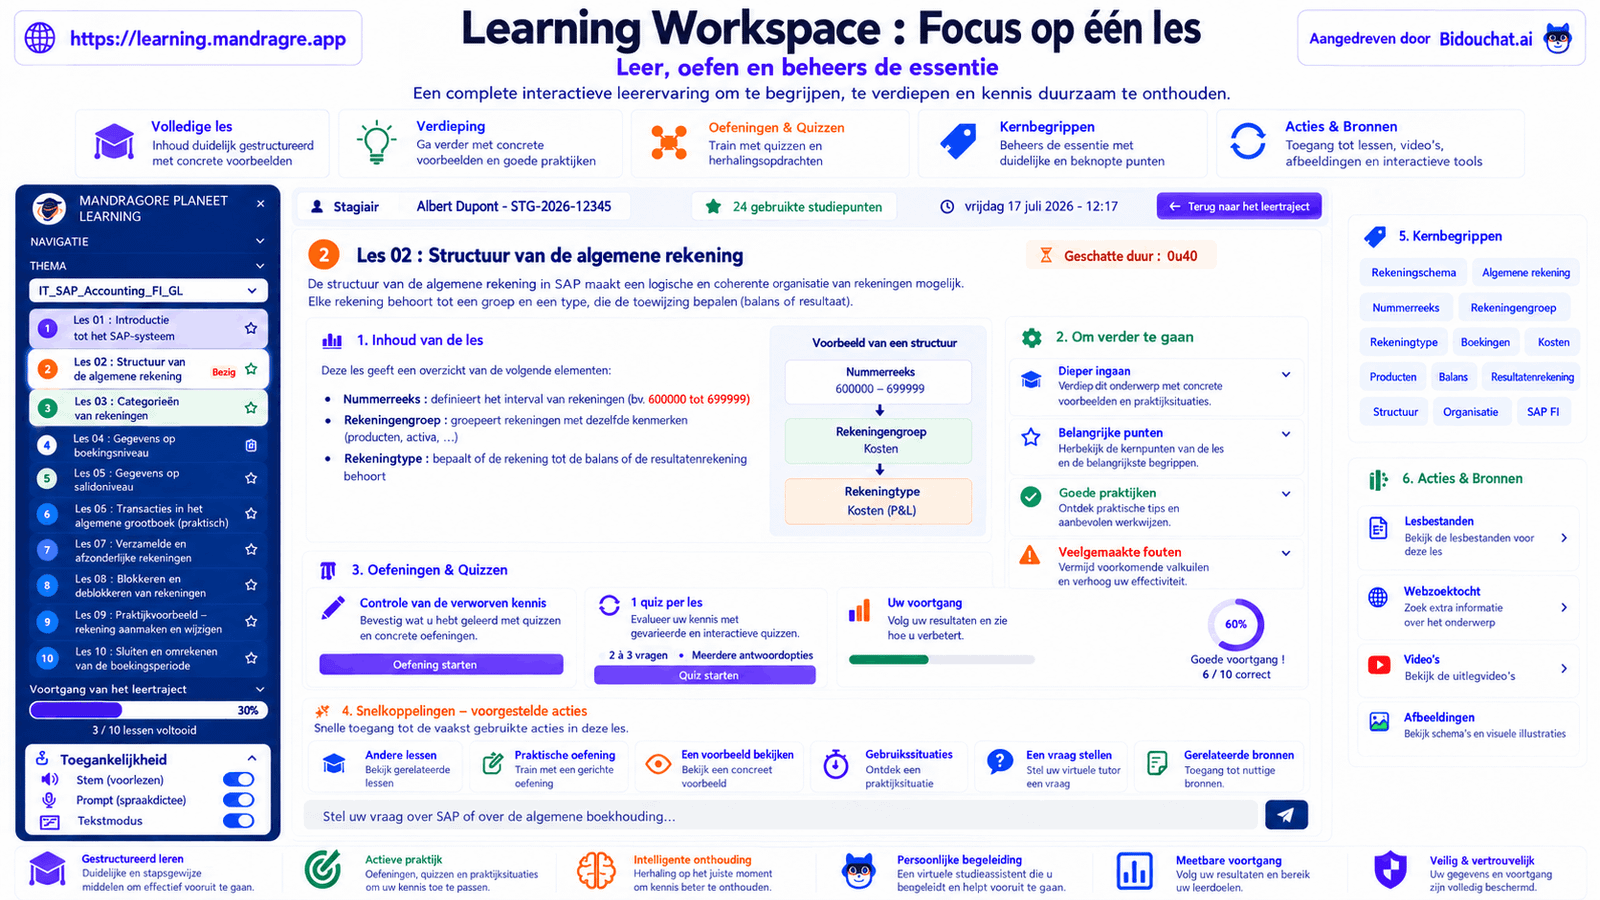
Elke cursus bevat 8 interactieve lessen in een Learning Workspace die is ontworpen om kennis om te zetten in operationele vaardigheden. Begeleide lessen, dynamische quizzen, begeleiding via gesprekken, praktijkcases, aanvullende bronnen en voortgangsregistratie helpen je om effectief en in je eigen tempo te leren. De 15 cursussen volgen een progressie op verschillende niveaus, van het vaststellen van een machine-learningprobleem tot het implementeren, begeleiden en verdedigen van een volledige voorspellende oplossing.
🎓 15 cursussen • 📚 120 interactieve lessen • ⏱️ 45 tot 75 uur opleiding via gesprekken
⭐ Beste aanbieding
Machinaal leren — Compleet pakket (15 leertrajecten)
ML01 → ML15 · 1 800 Uitgaven inclusief
142,90 € excl. btw
Besparing : 104,60 €
29,70 €
22,90 excl. btw
Besparing : 6,80 €
Machine Learning begrijpen en een probleem in kaart brengen
Een bedrijfsbehoefte omzetten in een meetbaar Machine Learning-probleem en bepalen of ML daadwerkelijk relevant is
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
Er zijn geen specifieke vereisten om te beginnen. Vertrouwdheid met digitale tools wordt aanbevolen; latere technische cursussen kunnen kennis van softwareontwikkeling of gegevensverwerking vereisen.
- Begrijpen wat Machine Learning werkelijk oplevert
- Identificeer classificatie, regressie en andere problemenfamilies
- Een baseline bouwen voor een complex model
- Workshop: beslissen of een probleem echt Machine Learning vereist
- Een bedrijfsbehoefte omzetten in een meetbaar Machine Learning-probleem en bepalen of ML daadwerkelijk relevant is
- Onderscheid maken tussen begeleid en ongeleid leren
- Het onderscheid tussen training, validatie en inferentie
- Workshop: beslissen of een probleem echt Machine Learning vereist
3 naar 5 h
9,90 € excl. btw
Voorbereiden en verkennen van data voor machine learning
het opbouwen van een werkbare dataset zonder dat er sprake is van bias, data leakage of inconsistenties;
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Onderzoek naar distributies, typen en kwaliteit van de gegevens
- Voorbereiding van numerieke en categorievariabelen
- Onbalans en onvoldoende representativiteit
- Workshop: auditen en voorbereiden van een dataset voor modellen
- Het bouwen van een werkbare dataset zonder het introduceren van bias, data leakage of inconsistenties
- Het hanteren van ontbrekende en afwijkende waarden
- Variabelen schalen wanneer het model dit vereist
- Workshop: auditen en voorbereiden van een dataset voor modellen
3 naar 5 h
9,90 € excl. btw
Het bouwen van een eerste reproduceerbare ML-pipeline
Voorbewerking, training, voorspelling en evaluatie verbinden in een reproduceerbare workflow
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Installeer een reproduceerbare ML-omgeving
- Het creëren van de pre-behandeling transformaties
- Het berekenen en verifiëren van de eerste metrics
- Workshop: levering van een eerste reproduceerbare ML-pipeline
- Voorbewerking, training, voorspelling en evaluatie verbinden in een reproduceerbare workflow
- Een baseline bouwen met scikit-learn
- De pipeline trainen en voorspellingen genereren
- Workshop: levering van een eerste reproduceerbare ML-pipeline
3 naar 5 h
9,90 € excl. btw
38,70 €
28,90 excl. btw
Besparing : 9,80 €
Regressieproblemen oplossen
het ontwerpen, vergelijken en evalueren van modellen voor het voorspellen van een cijferwaarde
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Begrijpen van een doorlopende doelstelling en bouwen van een baseline
- Begrijpen van regelgeving en het belang ervan
- R² interpreteren zonder het te overschatten
- Workshop: verschillende regressiemodellen vergelijken voor een bedrijfsbehoefte
- Ontwerp, vergelijking en evaluatie van modellen om een digitale waarde te voorspellen
- Een lineaire regressie bouwen
- Kies tussen MAE, MSE en RMSE
- Workshop: verschillende regressiemodellen vergelijken voor een bedrijfsbehoefte
3 naar 5 h
12,90 € excl. btw
Problemen met de classificatie oplossen
het bouwen van classificatiemodellen en het kiezen van metrics en drempels die passen bij de werkelijke kosten van fouten
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Het begrijpen van de klassen en het bouwen van een baseline
- Beslisbomen en Random Forest gebruiken
- Precision, recall en F1 vergelijken
- Workshop: kiezen van een classificator naar de kosten van de fouten
- Het bouwen van classificatiemodellen en het kiezen van metrics en drempels die geschikt zijn voor de werkelijke kosten van fouten
- Een logistieke regressie opbouwen
- Lees een verwarrende matrix
- Workshop: kiezen van een classificator naar de kosten van de fouten
3 naar 5 h
12,90 € excl. btw
Goed evalueren en vergelijken van modellen
een betrouwbare prestatie-schatting te verkrijgen en misleidende conclusies te vermijden bij het kiezen van een model;
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Begrijp het risico van een te optimistische evaluatie
- Evalueren met kruisvalidatie
- Het vergelijken van meerdere modellen over samenhangende metrics
- Workshop: bouwen aan een verdedigbaar evaluatieprotocol
- Een betrouwbare prestatie-schatting verkrijgen en misleidende conclusies vermijden bij de keuze van een model
- Een hold-out goed gebruiken
- De tijdsorde respecteren met een time split
- Workshop: bouwen aan een verdedigbaar evaluatieprotocol
3 naar 5 h
12,90 € excl. btw
47,70 €
35,90 excl. btw
Besparing : 11,80 €
Ontwerpen en selecteren van de functies
het creëren van informatieve variabelen zonder data leakage en het verminderen van complexiteit wanneer dit het model verbetert
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Begrijpen van de rol van feature engineering
- Tijdsvariabelen maken zonder informatielekken
- Gebruik maken van kenmerkenselectiemethoden
- Workshop: modelverbetering met gemotiveerde kenmerken
- Het creëren van informatieve variabelen zonder data leakage en het verminderen van complexiteit wanneer dit het model verbetert
- Het creëren van digitale variabelen en nuttige transformaties
- Redundantie en multilineariteit detecteren
- Workshop: modelverbetering met gemotiveerde kenmerken
3 naar 5 h
15,90 € excl. btw
Optimaliseren van modellen en hyperparameters
het verminderen van underfitting en overfitting en het zoeken naar hyperparameters zonder de eindbeoordeling te vervuilen
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Underfitting, overfitting, bias en variantie begrijpen
- Een Grid Search met kruisvalidatie opzetten
- Beheersing van rekentijd en onderzoekruimte
- Workshop: het uitvoeren en documenteren van een hyperparameters optimalisatie
- Verminderen van underfitting en overfitting en zoeken naar hyperparameters zonder de eindbeoordeling te besmetten
- Identificeer aangeleerde parameters en hyperparameters
- Kies voor de echt geoptimaliseerde metriek
- Workshop: het uitvoeren en documenteren van een hyperparameters optimalisatie
3 naar 5 h
15,90 € excl. btw
Het verkennen van de gegevens zonder labels
gebruik maken van clustering, dimensionering en anomaliedetectie om structuren te begrijpen zonder een gecontroleerd doelwit
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Begrijpen van de doelstellingen van onbegeleid leren
- Segmenteren met K-gemiddeld
- Omvang verminderen met PCA
- Workshop: bouwen en interpreteren van een exploratieve segmentatie
- Gebruik clustering, dimensionering en afwijkingsdetectie om structuren zonder toezicht te begrijpen
- Voorbereiding van de gegevens voor clustering
- Ontdek DBSCAN en onregelmatige clusters
- Workshop: bouwen en interpreteren van een exploratieve segmentatie
3 naar 5 h
15,90 € excl. btw
56,70 €
42,90 excl. btw
Besparing : 13,80 €
Modellen interpreteren, uitleggen en uitdagen
begrijpen welke factoren invloed hebben op voorspellingen en in welke situaties een verklaring onjuist kan zijn
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Een onderscheid maken tussen voorspellende prestaties en uitlegbaarheid
- Analyseer feature importance met zorg
- Ontdek de lokale SHAP-type verklaringen
- Workshop: een analyse van uitlegbaarheid met haar beperkingen
- Begrijp de factoren die de voorspellingen beïnvloeden en identificeer situaties waarin een verklaring misleidend kan zijn
- Interpretatie van coëfficiënten en eenvoudige parameters
- Begrijpen van de partiële afhankelijkheid plots
- Workshop: een analyse van uitlegbaarheid met haar beperkingen
3 naar 5 h
18,90 € excl. btw
Het beheer van onbalans, vooroordelen, robuustheid en betrouwbaarheid
evalueren van de kwaliteit van een model buiten een gemiddelde metriek en controleren van de risico's op populaties en moeilijke gevallen
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Identificeren van de gevolgen van een sterke klassenonevenwicht
- Metrics en drempels voor zeldzame gevallen kiezen
- Testing van robuustheid en gevoeligheid voor verstoorde gegevens
- Workshop: de betrouwbaarheid van een model uitdagen voor een beslissing
- Evalueren van de kwaliteit van een model buiten een gemiddelde metriek en controleren van de risico's op populaties en moeilijke gevallen
- Weging en resampling methodisch toepassen
- Performance vergelijken tussen subgroepen
- Workshop: de betrouwbaarheid van een model uitdagen voor een beslissing
3 naar 5 h
18,90 € excl. btw
Het traceren van experimenten en het beheren van modelversies
Experimenten vergelijkbaar, controleerbaar en reproduceerbaar maken en vervolgens de levenscyclus van modellen beheren
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Begrijp ervaring, run en ML-artifact
- Modellen, figuren en artefacten registreren
- Versies, aliases, tags en metadata beheren
- Workshop: bouwen aan de volledige traceerbaarheid van een kandidaatmodel
- Experimenten vergelijkbaar, controleerbaar en reproduceerbaar maken en vervolgens de levenscyclus van modellen beheren
- Met MLflow Tracking parameters en metrics registreren
- Een model registreren in de Model Registry
- Workshop: bouwen aan de volledige traceerbaarheid van een kandidaatmodel
3 naar 5 h
18,90 € excl. btw
74,70 €
48,90 excl. btw
Besparing : 25,80 €
Het begrijpen en toepassen van deep learning
De essentiële mechanismen van neurale netwerken begrijpen en een eenvoudig model trainen zonder het leertraject te laten uitwaaieren naar geavanceerde Deep Learning
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Tenseuren, lagen en neurale netwerken begrijpen
- Begrijpen van verliesfunctie en optimalisatie
- Een eenvoudig netwerk bouwen en trainen met PyTorch
- Workshop: vergelijk een eenvoudig netwerk met een klassieke baseline
- De essentiële mechanismen van neurale netwerken begrijpen en een eenvoudig model trainen zonder het leertraject te laten uitwaaieren naar geavanceerde Deep Learning
- Kies voor een eenvoudige architectuur en activering
- Batch, epoch en DataLoader gebruiken
- Workshop: vergelijk een eenvoudig netwerk met een klassieke baseline
3 naar 5 h
24,90 € excl. btw
Een ML-model implementeren, bewaken en onderhouden
Een gevalideerd model omzetten naar een bruikbare, geversioneerde, observeerbare en onderhoudbare productiedienst
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Een betrouwbaar artefact voor inferentie voorbereiden
- Een model blootleggen via een inferentie-API
- Monitor latency, fouten en kwaliteit van de inputdata
- Workshop: het uitvoeren en bewaken van een voorspellingsdienst
- Een gevalideerd model omzetten naar een bruikbare, geversioneerde, observeerbare en onderhoudbare productiedienst
- Het onderscheid tussen batch prediction en online inference
- Registratie, versies, promotie en rollback beheren
- Workshop: het uitvoeren en bewaken van een voorspellingsdienst
3 naar 5 h
24,90 € excl. btw
Volledig beroepsproject Machine Learning
een end-to-end ML-oplossing ontwerpen, evalueren, verklaren, versioneren, implementeren en verdedigen
Informatie over de opleiding
Data Analysts, Data Scientists, Machine Learning Engineers en ontwikkelaars die betrouwbare en reproduceerbare Machine Learning-oplossingen willen bouwen.
De basis van het leertraject kennen of de voorgaande cursussen hebben gevolgd. Eerder geïntroduceerde begrippen worden in deze cursus opnieuw toegepast en verder uitgediept.
- Het churnprobleem en de kosten van fouten afbakenen
- Pipelines, features en kandidaatmodellen bouwen
- Experimenten registreren en versies van het definitieve model beheren
- Finale workshop: presentatie en verdediging van de ML-oplossing en haar beperkingen
- Ontwerpen, evalueren, verklaren, versioneren, implementeren en verdedigen van een end-to-end ML-oplossing
- Voorbereiding van de gegevens en bouw van de baseline
- Analyse van segmenten, fouten en uitlegbaarheid
- Finale workshop: presentatie en verdediging van de ML-oplossing en haar beperkingen
3 naar 5 h
24,90 € excl. btw